QLC 的第 4 个 bit 为什么要写两遍:一个格子装 16 个峰
前言:上一篇留下的一句话
上一篇讲读取,结尾提了一句:QLC 有 15 个判断电平,读一次要问更多次。
那句话留了个尾巴——15 个电平是怎么来的? 或者说:为什么非要在一个格子里塞 4 个 bit?
先给结论:多存 1 个 bit,容量涨三分之一,但写要分两遍、读的次数也翻上去,而且这两件事你只能选一个吃亏。
这篇就把这笔账算清楚。
一、16 个峰:窗口没变,刀口更密
一颗 Cell 能耐多高的电压,是由器件结构决定的——氧化层多厚、耐压多少、可靠区间在哪。这些不会因为你多存一个 bit 而变宽。
所以从 TLC 到 QLC,变的是刀口,不是案板。
窗口总量基本不变,档数翻倍,于是每档的宽度减半。更麻烦的是电子数:能关进浮栅的电子总数没变,档数多了,两档之间差的电子数就只剩一半。
TLC 相邻状态差几十个电子,QLC 只剩十几个。而 retention、read disturb、随机噪声带来的扰动,并不会因为你要存 4 个 bit 就变客气。
这就是 QLC 全部困难的源头:不是“算不出来”,是余量不够用。
二、为什么不能一遍写到位
编程的本质,是加高压把电子赶进浮栅。这件事有副作用:同一个 word line 上的邻居在被写的时候,会顺带被加热一点(program disturb);相邻 Cell 之间的电容耦合,还会把彼此的 Vth 拽一下。
于是“一遍写 16 档”就出了矛盾:先落位的峰,要在邻居陆续写入的过程中一直等着,被干扰的时间最长,分布被抹得最宽。而 QLC 的余量本来就只剩一半,抹宽一点,峰就叠在一起了。
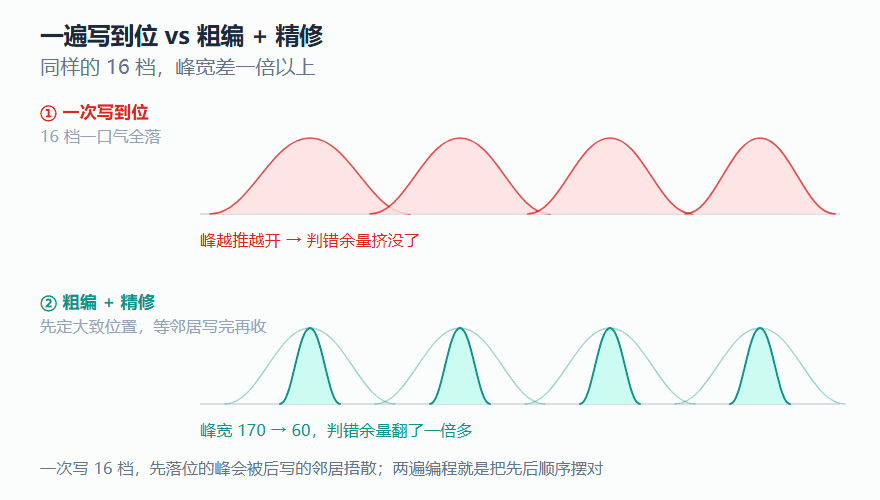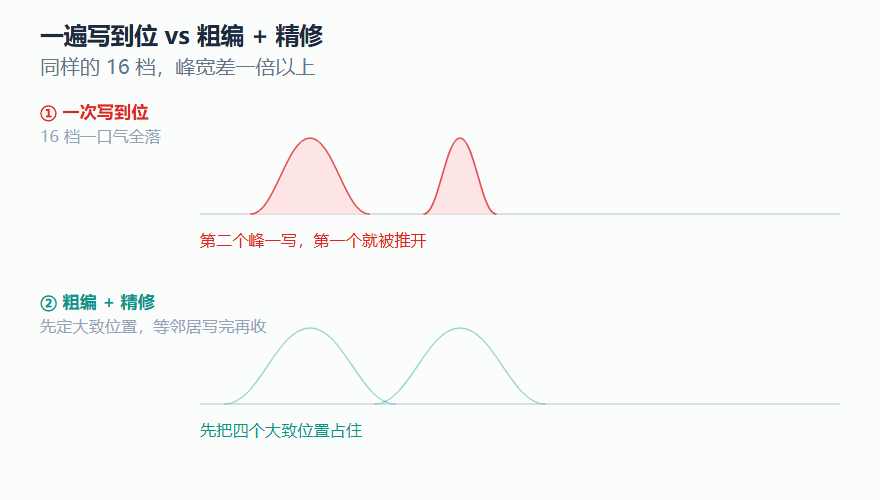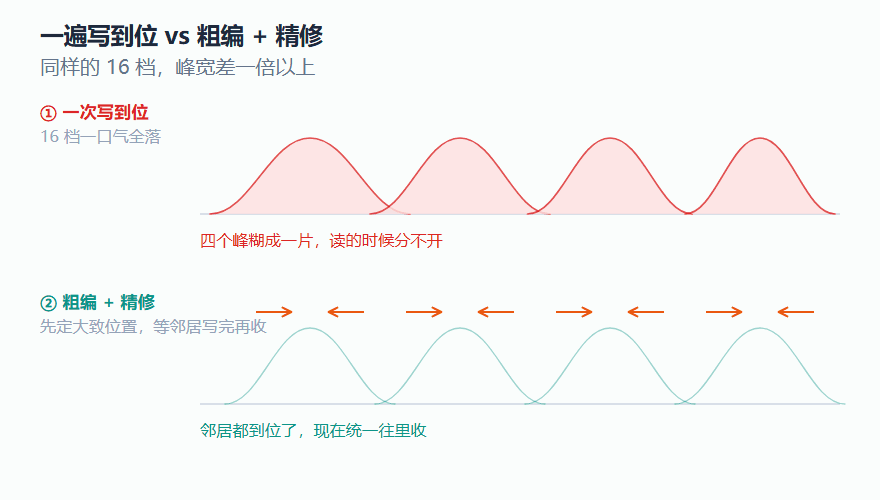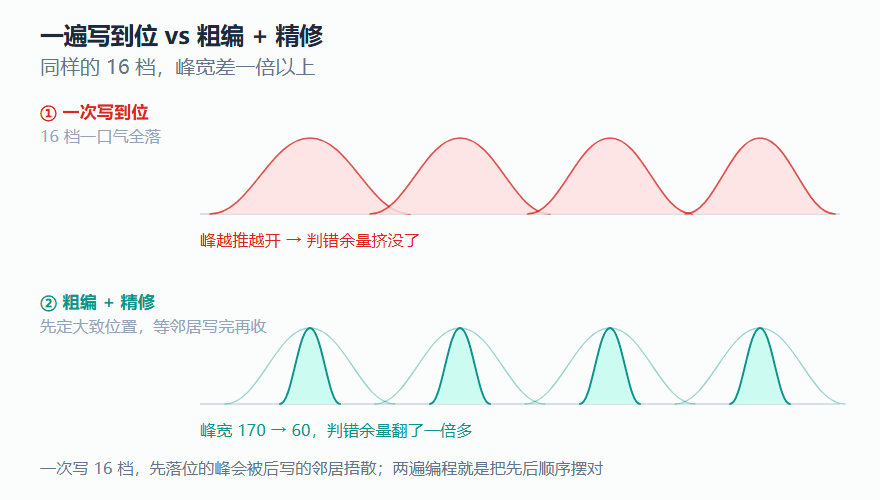
所以主流 QLC 都走“两遍”:先粗编把位置定个大概——分布宽一点没关系,位置对就行;等整条 word line 的邻居都写完了,再精修一遍,把每个峰往里收。
关键在最后一句:精修时偏移量小,带来的二次干扰也小。这不是玄学,是把干扰的时间窗错开。
三、两种两遍,一笔明账
同样叫两遍,粗编做到哪一档,结果完全不同。
8-16 方案:粗编只做 8 档(相当于先按 TLC 写一遍),精修再把每一档劈成两档。
- 粗编只需要 8 个验证电压,写得快;
- 代价在读:峰的位置在粗编时只定到 8 档,最高位那一页要靠多次判断组合出来,最差要问到 8 次(视方案而定),读窗口也最窄。
16-16 方案:粗编直接做 16 档,精修只负责收紧。
- 粗编要 15 个验证电压,每加一个验证就多一次判断,写得慢;
- 好处在读:峰的位置在粗编就定了,读的时候按常规 15 个电平判断即可,读得快、窗口宽。
这里讲的是两类方案的结构性差别,不是某一颗料的实测数据。具体编码方式、判定次数由厂商的编程算法与 ECC 方案决定,不同代次差别不小。看到具体数字,先问一句“这是哪家、哪一代、什么条件下”。
所以 QLC 没有免费的选择:要写得快,就拿读来换;要读得快,就拿写来换。 选哪条,取决于这块盘被拿来干什么。
四、落到产品上
这笔账最终会以三种样子出现在你面前。
第一,QLC 盘几乎都离不开 SLC Cache。 顺序写 QLC 本来就慢,主机又不会等你,所以写入先按 SLC 落到一小块区域(快、但只占容量的一小点),空闲时再往 QLC 搬。跑分软件测的是前半段,你日常感受到的是后半段。
第二,企业级 QLC 主打读密集。 AI 推理的数据集、内容分发、备份归档——写一次、读很多次,正好压在 16-16 方案的强项上。反过来,拿 QLC 跑数据库的随机写,就是拿短板去撞墙。
第三,PLC 至今没量产。 再切一半,余量基本归零,retention 和干扰都撑不住。省下来的那点成本,抵不上可靠性要赔的——这是产业界的普遍判断,不是某一家公开的官方结论。
所以下次看到“QLC 顺序写 1 GB/s、随机写掉到几百 MB/s”,不用怀疑盘坏了。那是介质在收账。
结语:峰越挤,越靠外层兜
QLC 把“余量”这件事逼到了极限。它比 TLC 更依赖 ECC、更依赖 read retry、更依赖缓存——这些都在后面几篇里。
但在这之前,还有一个问题得先回答:峰摆好了,读的时候怎么把这一堆挨得很近的峰分开?
回到那条主线。下一篇,看“读”——TLC 的 7 个判断电压、QLC 的 15 个,读一页时其实只用到其中两三个。
我们下一篇见。